Secuenciación genómica para investigaciones de contaminación explicada
La secuenciación genómica lee la huella genética exacta de un patógeno. Así es como rastrea la contaminación hasta su fuente más rápido que nunca.

Introducción
Imagina una historia detectivesca donde el culpable es invisible a simple vista, se desplaza a través de alimentos, agua o equipos hospitalarios, y puede enfermar a miles de personas antes de que alguien siquiera note un patrón. Esta es exactamente la situación a la que se enfrentan los investigadores de salud cuando estalla un brote de enfermedad — ya sea por lechuga contaminada, un lote de fórmula infantil, el suministro de agua de un hospital o una línea de producción farmacéutica.
Durante décadas, los investigadores dependieron de pruebas de laboratorio tradicionales que podían decirles qué tipo de bacteria estaba presente, pero no mucho más. Hoy en día, una herramienta mucho más poderosa ha tomado el protagonismo: la secuenciación genómica.
En términos sencillos, la secuenciación genómica lee el código genético completo —el ADN— de un microorganismo, letra por letra. Esta "huella digital" genética es tan detallada que puede distinguir entre dos bacterias que se ven idénticas al microscopio pero que, genéticamente, están a años luz. Cuando ocurre una contaminación, esta tecnología permite a los científicos rastrear la cepa exacta de un patógeno, vincularla con su fuente y cerrar el problema antes de que se propague más.
Este artículo explica, en lenguaje claro, cómo funciona la secuenciación genómica, por qué se ha convertido en el estándar de oro para las investigaciones de contaminación y qué impacto real ha tenido en la seguridad alimentaria, la atención sanitaria y la salud pública.
¿Qué es realmente la secuenciación genómica?
Todo organismo vivo, incluidas las bacterias y los virus, porta material genético formado por ADN (o ARN en algunos virus). Este material genético actúa como un manual de instrucciones, escrito en un código compuesto por solo cuatro "letras" — A, T, C y G. La secuenciación genómica es el proceso de leer este manual de instrucciones completo de principio a fin.
La versión de esta técnica más utilizada en las investigaciones de contaminación se llama “Whole Genome Sequencing (WGS)”. A diferencia de los métodos antiguos que solo examinaban partes pequeñas y específicas del código genético de una bacteria, WGS captura el genoma completo del organismo —cada gen, cada mutación, cada pequeña variación.
Aquí hay una manera simple de pensarlo:
Los métodos antiguos eran como comprobar la altura y el color de ojos de una persona para identificarla.
WGS es como tomar su huella dactilar completa, perfil de ADN e historial médico completo al mismo tiempo.
Este nivel de detalle permite a los investigadores distinguir entre dos cepas de la misma especie bacteriana incluso si difieren por apenas un puñado de letras genéticas, una resolución que antes era simplemente imposible.
¿Por qué los métodos antiguos se quedaban cortos?
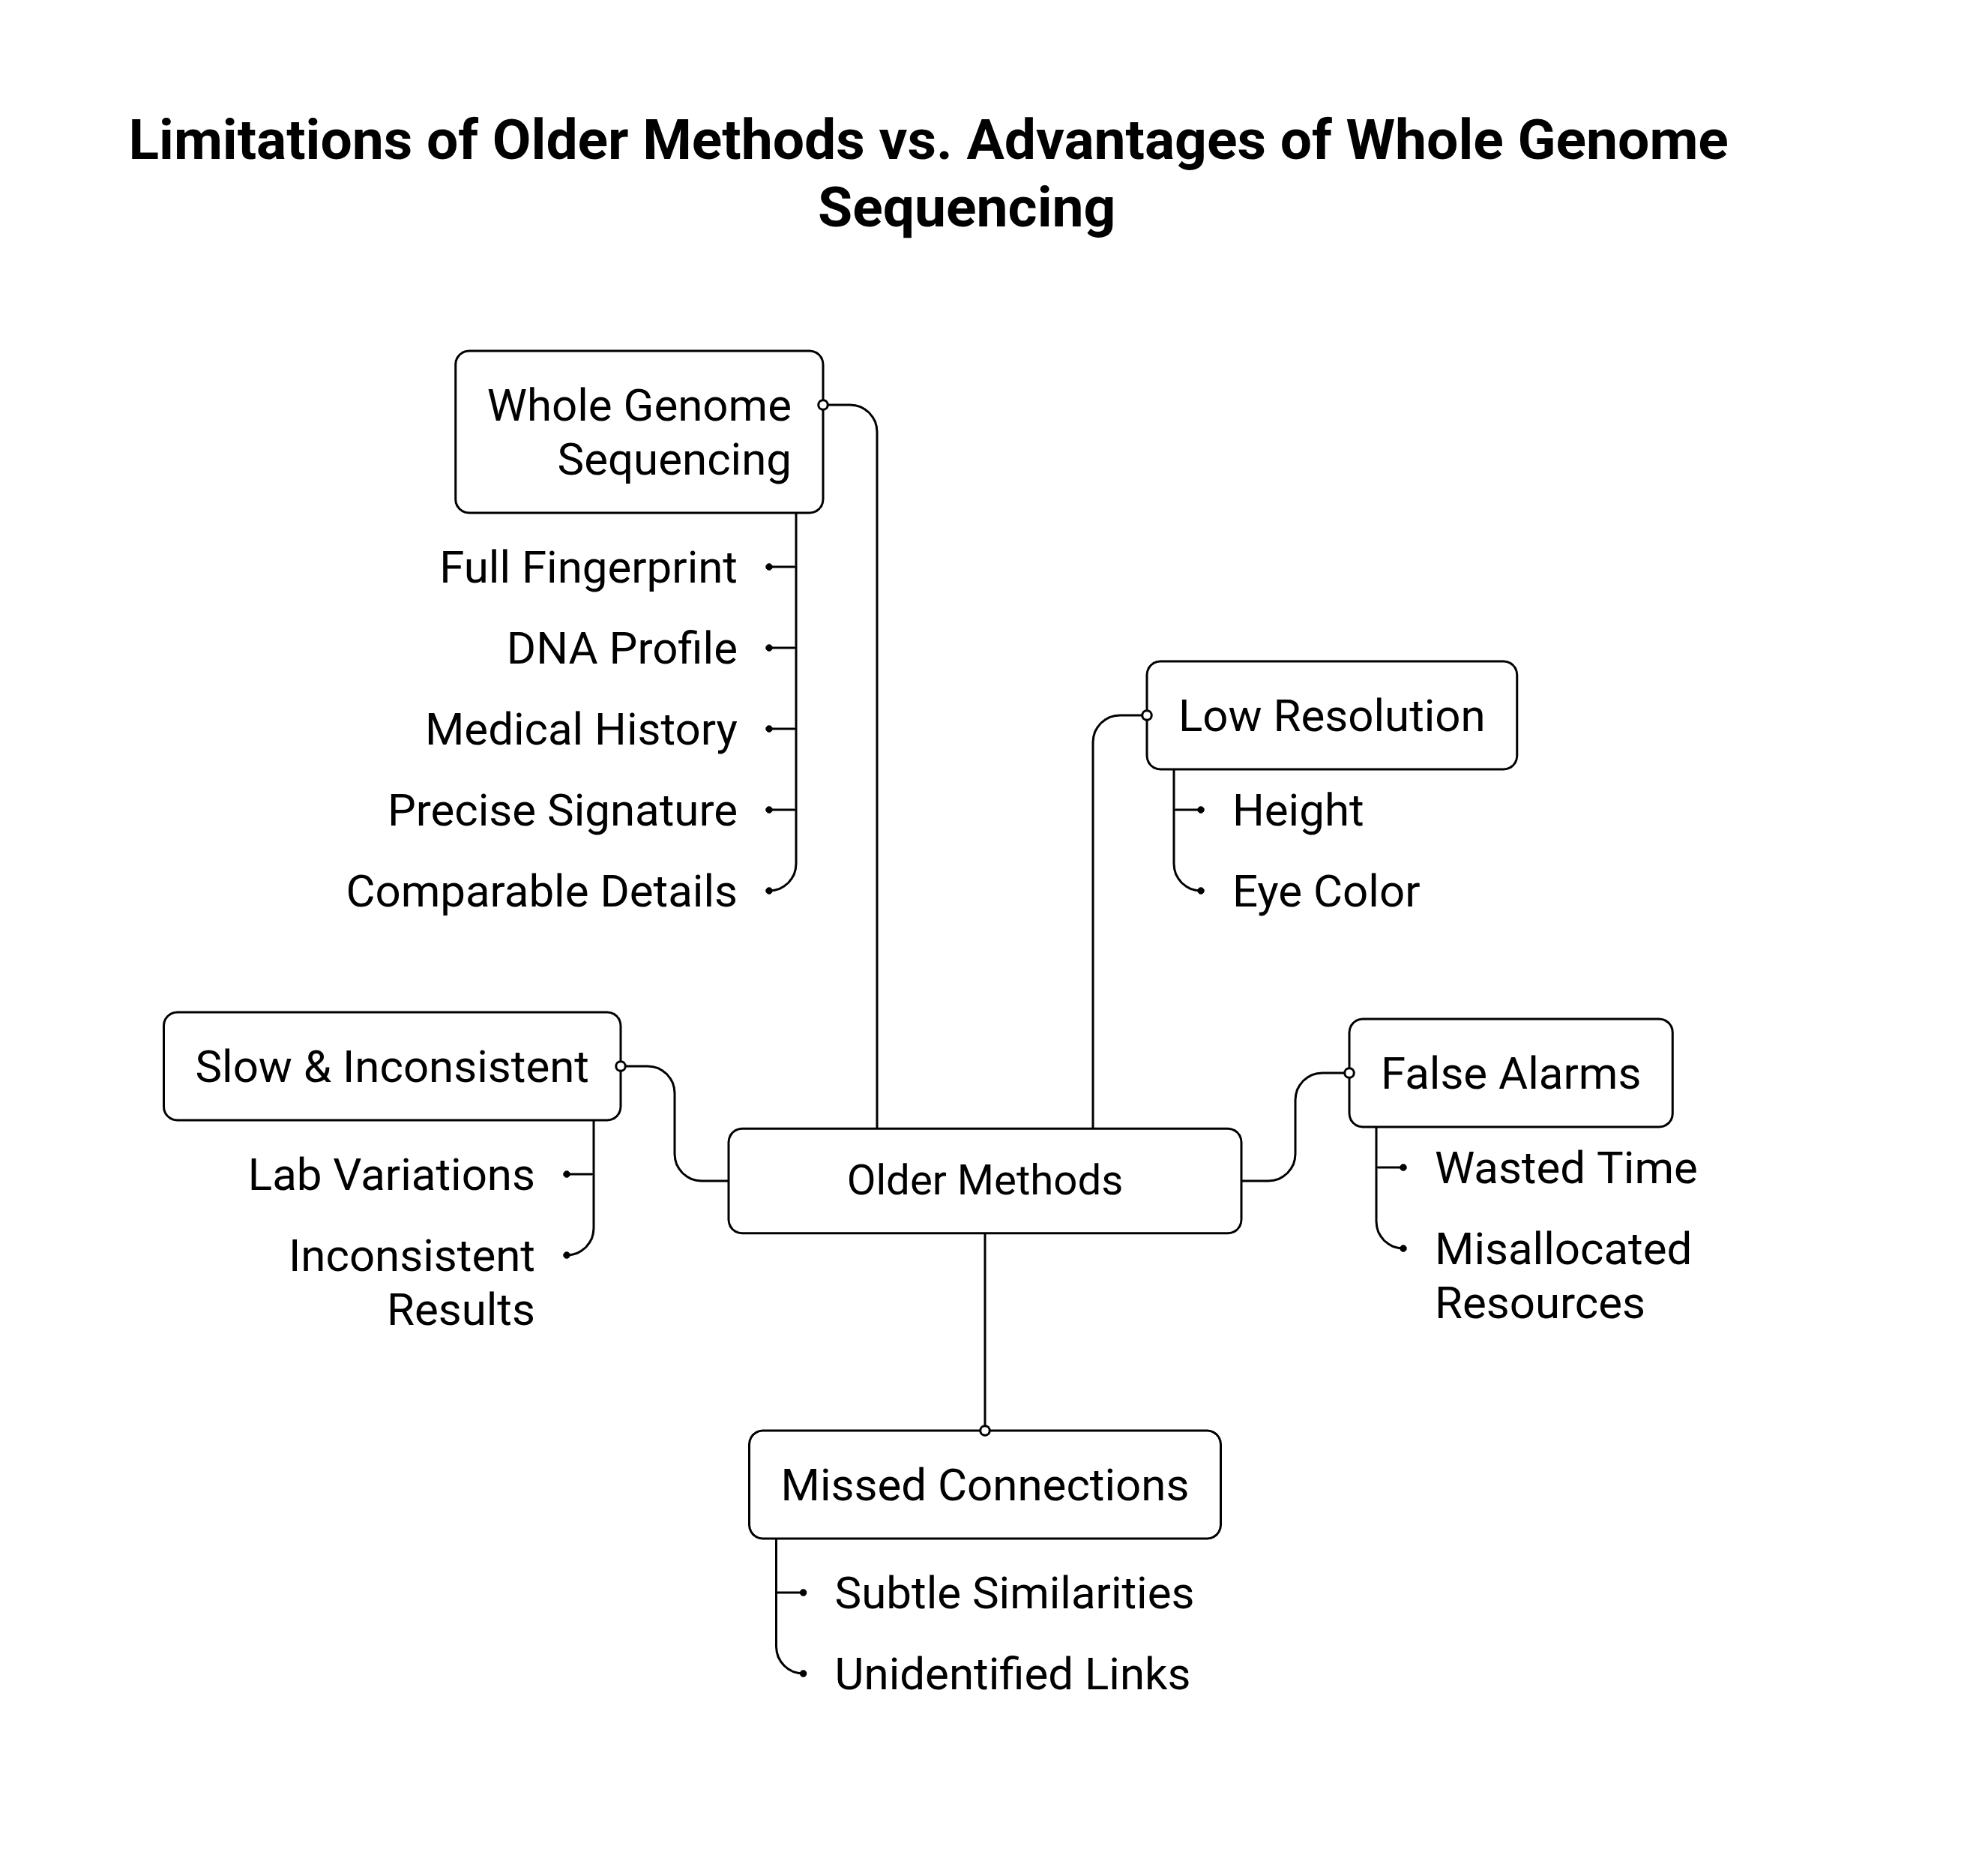
Antes de que WGS se hiciera común, los investigadores usaban mayormente una técnica llamada Pulsed-Field Gel Electrophoresis (PFGE), junto con cultivo básico y serotipado. Estos métodos funcionaban razonablemente bien pero tenían limitaciones reales:
1) Baja resolución
PFGE solo podía separar las bacterias en categorías amplias, a veces agrupando cepas no relacionadas simplemente porque se parecían.
2) Falsas alarmas
Debido a la baja resolución, los investigadores a veces pensaban que habían encontrado un clúster de brote cuando los casos en realidad no estaban relacionados — desperdiciando tiempo y recursos.
3) Conexiones perdidas
Por otro lado, algunos casos genuinamente vinculados se pasaban por alto porque las técnicas antiguas no podían detectar las sutiles similitudes genéticas entre ellos.
4) Lentitud e inconsistencia
Los resultados podían variar entre laboratorios, lo que dificultaba comparar datos entre regiones o países.
La secuenciación genómica resolvió la mayoría de estos problemas al brindar a cada caso una firma genética precisa, comparable y altamente detallada.
¿Cómo funciona la secuenciación genómica en una investigación de contaminación?
Aunque la ciencia detrás de las máquinas de secuenciación es compleja, el proceso general de investigación es bastante fácil de seguir. Generalmente ocurre en estos pasos:
Recolección de muestras: Los investigadores recogen muestras de pacientes enfermos, productos alimentarios sospechosos, fuentes de agua o superficies ambientales (como el desagüe de una fábrica o el fregadero de un hospital).
Aislamiento del organismo: Los técnicos de laboratorio cultivan la bacteria o el virus en un entorno controlado para que haya suficiente material genético con el que trabajar.
Extracción del ADN: El material genético se separa del resto de la célula.
Secuenciación: Una máquina de secuenciación lee el ADN y lo convierte en un código digital —esencialmente una larga cadena de A, T, C y G.
Comparación de genomas: Potente software informático compara el código genético de diferentes muestras para ver qué tan estrechamente relacionadas están.
Construcción de un árbol genealógico: Con los datos de comparación, los científicos construyen lo que se llama un árbol filogenético —un mapa visual que muestra cómo están genéticamente relacionadas las diferentes muestras, casi como un árbol genealógico para bacterias.
Coincidencia con una fuente: Si una cepa de un paciente enfermo coincide de cerca con una cepa encontrada en un producto alimentario o una muestra ambiental, los investigadores tienen evidencia sólida que vincula la enfermedad con esa fuente específica.
Este flujo de trabajo completo permite a las agencias sanitarias pasar de una sospecha vaga ("algo está enfermando a la gente") a pruebas sólidas ("esta cepa exacta, procedente de esta instalación exacta, causó estas enfermedades exactas").
Sistemas del mundo real que hacen esto posible
La secuenciación genómica no es solo una técnica de laboratorio: está respaldada por grandes redes coordinadas que comparten datos entre ciudades, estados e incluso países. Dos ejemplos bien conocidos en Estados Unidos incluyen:
PulseNet, coordinada por laboratorios de salud pública, que conecta cientos de laboratorios utilizando métodos de secuenciación estandarizados para que un caso detectado en un estado pueda compararse rápidamente con casos en otras zonas.
GenomeTrakr, una red coordinada con agencias regulatorias de seguridad alimentaria, que se centra en la secuenciación de bacterias encontradas en muestras de alimentos y ambientales y en subirlas a una base de datos pública compartida.
Debido a que estas redes utilizan protocolos estandarizados, un brote de enfermedades en un lado del país puede coincidir, en cuestión de días, con un producto contaminado identificado en el otro extremo. Este tipo de comparación rápida y a gran escala simplemente no era posible con técnicas de laboratorio más antiguas.
Por qué esto importa: ¿los beneficios prácticos?
El cambio hacia la secuenciación genómica ha transformado las investigaciones de contaminación de varias maneras importantes:
Velocidad – Los brotes se identifican y confirman más rápido, lo que significa que los productos contaminados pueden retirarse de las estanterías antes.
Precisión – Los investigadores pueden descartar con confianza casos no relacionados, evitando esfuerzos desperdiciados persiguiendo pistas falsas.
Trazado preciso del origen – En lugar de decir simplemente "los vegetales de hoja causaron este brote", los investigadores a menudo pueden rastrear el problema hasta una granja específica, una instalación de procesamiento o una fuente de agua concreta.
Detección de riesgos ocultos – La secuenciación también puede revelar si una cepa bacteriana porta genes de resistencia a antibióticos o de producción de toxinas, lo que ayuda a los médicos a elegir el tratamiento adecuado y a los reguladores a evaluar qué tan peligroso es realmente un evento de contaminación.
Seguimiento transfronterizo – Dado que las enfermedades transmitidas por alimentos suelen cruzar fronteras internacionales, las bases de datos de secuencias globales compartidas ayudan a conectar brotes que de otro modo podrían parecer incidentes aislados y no relacionados en distintos países.
Los métodos microbiológicos rápidos también están transformando la velocidad de detección de la contaminación. Vea cómo los RMM están cambiando el monitoreo ambiental en salas limpias.
→ Leer: Los métodos microbiales rápidos transforman el EM farmacéutico
Más allá de los alimentos: otras áreas donde se utiliza esta tecnología
Si bien la seguridad alimentaria es una de las aplicaciones más visibles, la secuenciación genómica para investigaciones de contaminación se extiende mucho más allá:
a) Infecciones asociadas a la atención sanitaria: La secuenciación ayuda a los hospitales a rastrear brotes de bacterias resistentes a medicamentos hasta una sala específica, un equipo o incluso un único trabajador de la salud que podría estar propagándola sin saberlo.
b) Fabricación farmacéutica: Los fabricantes de medicamentos utilizan la secuenciación para identificar la fuente de la contaminación microbiana en entornos de producción, protegiendo la seguridad de los medicamentos.
c) Sistemas de agua: Las compañías de agua públicas la usan para rastrear eventos de contaminación hasta tuberías específicas, fallos de tratamiento o fuentes ambientales.
d) Monitoreo ambiental e industrial: Las instalaciones que manejan materias primas o productos biológicos utilizan la secuenciación para detectar la contaminación temprano, antes de que se convierta en un problema generalizado.
La secuenciación genómica funciona junto con estrategias más amplias de control de la contaminación en la fabricación estéril. Vea cómo los microbiólogos anclan estos sistemas de seguridad.
→ Leer: Microbiólogos | La columna vertebral de la seguridad HACCP
Desafíos que aún existen
La secuenciación genómica es poderosa, pero no es una solución mágica para todas las situaciones. Algunos desafíos en curso incluyen:
Costo e infraestructura — No todos los laboratorios, especialmente en regiones con menos recursos, tienen acceso a equipos de secuenciación o personal capacitado.
Obstáculos para el intercambio de datos — Coordinación de datos entre diferentes países y agencias implica navegar preocupaciones de privacidad, regulaciones distintas y problemas de compatibilidad técnica.
Complejidad de interpretación — El enorme volumen de datos genéticos generados requiere analistas especializados y gran potencia informática para interpretarlos correctamente.
Estandarización — Diferentes laboratorios a veces utilizan plataformas de secuenciación o flujos de análisis ligeramente distintos, lo que puede generar pequeñas inconsistencias que deben gestionarse con cuidado.
En conclusión
La secuenciación genómica ha transformado las investigaciones de contaminación de un proceso lento e incierto a una ciencia rápida y precisa. Al leer el plano genético completo de bacterias y virus, los investigadores ahora pueden identificar brotes antes, rastrearlos hasta su fuente exacta y prevenir daños adicionales con un nivel de confianza que los métodos antiguos simplemente no podían ofrecer. Desde productos alimentarios contaminados hasta infecciones hospitalarias y sistemas de agua, esta tecnología se ha convertido en una guardiana silenciosa pero esencial de la salud pública.
A medida que la tecnología de secuenciación se vuelve más barata, rápida y accesible, es probable que su papel en las investigaciones de contaminación siga creciendo — ayudando a los investigadores a resolver estos misterios invisibles no solo más rápido, sino con mucha más precisión que nunca. Lo que antes era un juego de conjeturas laborioso se ha convertido en una ciencia basada en datos, y ese cambio está salvando vidas genoma a genoma.
Preguntas frecuentes
1. ¿Qué es la secuenciación genómica y cómo ayuda a identificar la contaminación?
La secuenciación genómica lee el material genético de un microorganismo para crear un perfil genético detallado. Los investigadores pueden comparar estos perfiles para determinar si los microorganismos de diferentes muestras están estrechamente relacionados y posiblemente vinculados al mismo evento de contaminación.
2. ¿Por qué se utiliza la secuenciación del genoma completo en las investigaciones de contaminación?
La secuenciación del genoma completo (WGS) examina el genoma completo de un organismo, proporcionando mucho más detalle que los métodos de prueba anteriores. Esto permite a los investigadores distinguir entre cepas estrechamente relacionadas e identificar conexiones que de otro modo podrían pasarse por alto.
3. ¿Cómo ayuda la secuenciación genómica a rastrear la fuente de un brote?
Los investigadores secuencian microorganismos recolectados de pacientes, alimentos, agua, equipos o superficies ambientales y comparan sus perfiles genéticos. Una coincidencia genética cercana puede aportar pruebas sólidas de que las muestras provienen de la misma fuente o forman parte del mismo brote.
4. ¿Dónde se utiliza la secuenciación genómica en las investigaciones de contaminación?
La secuenciación genómica se utiliza en varias áreas, incluidas la seguridad alimentaria, la atención médica, la fabricación farmacéutica, los sistemas de agua y la monitorización ambiental. Puede ayudar a identificar fuentes de contaminación y rastrear la propagación de microorganismos entre diferentes ubicaciones.
5. ¿Cuáles son los principales desafíos de usar la secuenciación genómica?
Los principales desafíos incluyen el costo del equipo de secuenciación, la necesidad de personal capacitado, el análisis complejo de datos, las diferencias en los métodos de laboratorio y las dificultades para compartir datos entre organizaciones o países. Estos factores pueden afectar la rapidez y eficacia con la que se utilizan los resultados de la secuenciación.
Reporting on the science, business and regulation shaping the pharmaceutical industry.
Más en Regulatory Intelligence
Todos los artículos →
El patrón detrás de las FDA Warning Letters: lo que las startups y los CDMO suelen pasar por alto

Clases de salas limpias ISO 14644 para la industria farmacéutica (con implicaciones para EM)

Discussion