I regolatori possono fidarsi dei dati scientifici generati dall'IA?
La FDA ha oltre 500 submission basate su IA e il numero è in crescita. I tassi di allucinazione raggiungono il 55% su argomenti di nicchia. Ecco il quadro di fiducia regolatorio che l'industria farmaceutica deve comprendere.
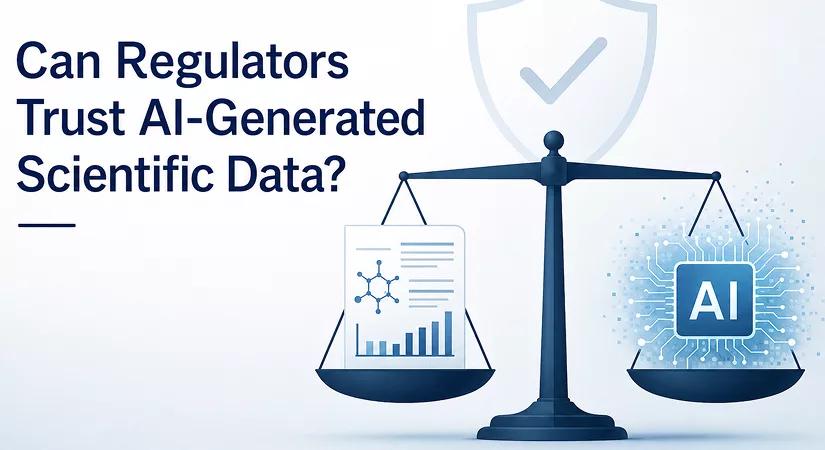
Per decenni, il rapporto tra un ente regolatorio e i dati scientifici a esso sottoposti si basava su un assunto semplice: un essere umano ha condotto l’esperimento, un essere umano ha registrato il risultato e un essere umano poteva essere ritenuto responsabile se quel risultato si fosse rivelato errato.
L’intelligenza artificiale ha silenziosamente smantellato quell’assunto. I modelli di AI ora generano, analizzano, riassumono e, in alcuni casi, producono direttamente i dati scientifici che le aziende farmaceutiche presentano a supporto delle approvazioni di farmaci, della progettazione di studi clinici e delle decisioni sulla qualità della produzione.
La domanda che questo solleva non è più teorica o ipotetica. Sta rapidamente diventando la sfida regolatoria centrale del decennio in corso: un ente può davvero fidarsi di un risultato scientifico che nessun essere umano ha prodotto, verificato o testimoniato direttamente?
La portata di questo cambiamento è già notevole:
- La FDA segnala oltre 500 sottomissioni regolatorie con componenti AI dal 2016, con un uso descritto internamente in crescita "esponenziale"
- Quasi 950 dispositivi medici abilitati da AI o machine learning erano stati approvati dalla FDA ad agosto 2024, rispetto ai soli 520 di gennaio 2023
- Un sondaggio cross-settore del 2025 ha rilevato che il 44% delle organizzazioni ha subito conseguenze negative dall’uso di AI generativa, con perdite finanziarie medie di $4.4 milioni per incidente
- Ricerche indipendenti 2025–2026 hanno riscontrato che perfino avanzati modelli di grandi dimensioni mostrano tassi di allucinazione del 15–20% nei compiti di citazione fattuale, salendo al 35–55% su argomenti di nicchia o recenti
Questi numeri inquadrano una tensione reale e crescente all’interno dell’establishment scientifico: l’AI si sta strutturalmente integrando nella pipeline dei dati regolatori proprio nel momento in cui la sua propensione a fabbricazioni plausibili e sicure di sé è sempre meglio documentata e più difficile da ignorare.
La risposta della FDA: un quadro di credibilità basato sul rischio
Piuttosto che ignorare il problema o tentare di vietare l’uso dell’AI nelle sottomissioni regolatorie, la FDA ha proceduto deliberatamente a costruire una struttura valutativa formale. Nel gennaio 2025 l’agenzia ha pubblicato una bozza di linee guida intitolata “Considerations for the Use of Artificial Intelligence to Support Regulatory Decision-Making for Drug and Biological Products (FDA-2024-D-4689)” — il primo documento di orientamento dell’agenzia che affronta specificamente l’AI usata per generare o analizzare dati presentati a supporto di una decisione regolatoria.
Il concetto centrale introdotto in questa guida è la "credibilità del modello" — definita come la fiducia nella performance di un modello di AI per un particolare Contesto d’Uso (COU). Criticamente, la FDA non considera la credibilità dell’AI come un giudizio binario sì/no.

Viene valutata in relazione a come esattamente l’output del modello verrà utilizzato e quale rischio comporta quell’uso specifico. La guida propone un processo di valutazione della credibilità in sette passaggi basato sul rischio:
- Definire la questione di interesse che il modello di AI è utilizzato per affrontare
- Definire il contesto d’uso, il ruolo specifico e l’ambito del modello all’interno della sottomissione regolatoria
- Valutare il rischio del modello di AI, considerando sia l’influenza del modello sulla decisione regolatoria sia la conseguenza che deriverebbe da un errore del modello
- Sviluppare un piano di valutazione della credibilità, adattato al livello di rischio identificato
- Eseguire il piano di valutazione della credibilità, generando le evidenze necessarie a supportare la fiducia nel modello
- Documentare i risultati in un formato trasparente e verificabile adatto alla revisione regolatoria
- Determinare l’adeguatezza, ovvero se le evidenze di credibilità supportano sufficientemente l’uso previsto del modello nella sottomissione
Questo quadro rappresenta una filosofia regolatoria fondamentalmente diversa dall’imposizione di requisiti di validazione uniformi e generalizzati. Un modello usato per smistare i report di eventi avversi per una revisione umana comporta un rischio diverso rispetto a un modello usato per generare l’endpoint di efficacia primario in uno studio fondamentale, e il quadro della FDA è esplicitamente progettato per richiedere prove proporzionalmente maggiori all’aumentare della posta in gioco.
Il quadro di credibilità della FDA fissa lo standard.
Ecco come l’AI sta già trasformando nella pratica le sottomissioni regolatorie farmaceutiche.
→ IA nell'industria farmaceutica | Trasformare la normativa
Perché l’allucinazione è il problema centrale di fiducia?
La minaccia più rilevante per la fiducia regolatoria nei dati generati dall’AI non è il bias o un malfunzionamento tecnico nel senso convenzionale, ma l’allucinazione: la tendenza dei modelli generativi di AI a produrre informazioni fabbricate dichiarandole con la stessa sicurezza delle informazioni accurate. Questo non è un raro caso limite. È una caratteristica strutturale di come i modelli di grandi dimensioni generano output.
Le prove della gravità di questo problema abbracciano molteplici domini scientifici:
- Un’analisi di gennaio 2026 condotta da GPTZero su 4.841 articoli accettati a NeurIPS 2025, una delle conferenze AI più competitive e rigorosamente sottoposte a peer review al mondo, ha riscontrato almeno 100 citazioni allucinate confermate in 53 articoli, nonostante la revisione da parte di tre-cinque revisori esperti per sottomissione
- L’allucinazione si manifesta non solo come citazioni fabricate ma come riassunti di dati inventati, risultati sperimentali inventati e interi manoscritti in stile paper-mill
- Nei domini medico e legale in particolare, i tassi di allucinazione possono superare il 28% senza adeguate tecniche di ancoraggio, anche con sistemi di generazione arricchita da retrieval progettati per ridurre il problema
- Un’analisi dell’industria farmaceutica ha rilevato che il 44% delle organizzazioni che utilizzano AI generativa ha riportato conseguenze negative, con output allucinati o fabbricati presentati con fiducia ingiustificata identificati come la barriera centrale alla fiducia clinica
Ciò che rende la <em>hallucination</em> particolarmente pericolosa in un contesto regolatorio è che non appare come un errore. Un sommario di dati clinici hallucinato, una citazione fabbricata a supporto di un'affermazione di sicurezza o un risultato sperimentale inventato possono superare una revisione superficiale proprio perché sono generati per risultare plausibili, ben formattati e internamente coerenti, le esatte qualità che rendono i dati scientifici legittimi affidabili.
La <em>hallucination</em> nei dati regolatori non si ferma alla sottomissione.
Quando raggiunge la pratica clinica, diventa un rischio per la sicurezza del paziente.
→ Allucinazioni dell'AI nella farmaceutica | Il rischio per la sicurezza del paziente
Dati sintetici: una categoria diversa di problema di fiducia
Una sfida distinta ma correlata riguarda i dati sintetici — set di dati generati da modelli AI (spesso Generative Adversarial Networks o diffusion models) per integrare dati reali limitati o soggetti a restrizioni di privacy, in particolare nella progettazione di trial clinici e nell'imaging medico.
I dati sintetici non sono lo stesso problema della <em>hallucination</em>; sono generati intenzionalmente, non fabbricati spontaneamente. Ma sollevano proprie questioni di fiducia distinte per i regolatori.

Le preoccupazioni principali con cui i regolatori si stanno confrontando attualmente includono:
1. Shift di distribuzione e realismo non verificabile — i record di pazienti sintetici o i dati di trial possono somigliare statisticamente a popolazioni reali senza però catturare realmente le patologie rare, i casi limite o le sfumature demografiche presenti nei dati clinici genuini
2. Amplificazione dei bias — ricerche nell'imaging mammario hanno riscontrato che i dati sintetici possono attenuare o, se mal applicati, amplificare attivamente i bias tra sottogruppi di pazienti, inclusi età, densità tissutale ed etnia
3. Provenienza e auditabilità — i regolatori devono poter tracciare esattamente come i dati sintetici sono stati generati, su quali dati reali sono stati addestrati e se quei dati di addestramento contengono a loro volta bias o problemi di qualità
4. Punteggio di fedeltà — le migliori pratiche emergenti richiedono che i dati sintetici siano corredati da punteggi di fedeltà documentati, con sistemi AI che segnaleranno esplicitamente o respingeranno automaticamente le previsioni basate su input sintetici a bassa fedeltà invece di presentarle con fiducia ingiustificata
Una review del 2025 sui dati sintetici nell'AI per la salute ha concluso che un uso responsabile richiede uno spostamento fondamentale dalla quantità alla qualità verificabile — un principio sempre più ripreso sia nelle linee guida FDA sia EMA mentre entrambe le agenzie convergono verso aspettative condivise per l'AI nella scienza regolatoria.
L'infrastruttura regolatoria in costruzione per rispondere alla questione della fiducia
Riconoscendo che nessun singolo documento di orientamento può risolvere completamente questa sfida, la FDA ha sviluppato un'infrastruttura organizzativa dedicata per gestire la supervisione dell'AI in modo continuativo. Ciò include:
- The Digital Health Center of Excellence (DHCoE), ospitato all'interno del Center for Devices and Radiological Health, che coordina le politiche su AI e digital health all'interno dell'agenzia
- The Digital Health Advisory Committee (DHAC), un comitato esterno di esperti che ha tenuto la sua riunione inaugurale nel novembre 2024 per fornire orientamenti sulle questioni AI in rapida evoluzione
- Due nuovi consigli inter-agenzia istituiti nel 2025: un External Policy Council che definisce principi per l'AI nei prodotti regolamentati, e un **Internal Use Council che sovrintende a come la FDA stessa utilizza l'AI nei propri processi di revisione
- Joint FDA-EMA Guiding Principles, attesi per allineare le aspettative regolatorie internazionali per la valutazione della credibilità dell'AI entro i primi mesi del 2026
Il periodo di commento pubblico sulla bozza di linee guida della FDA di gennaio 2025 si è chiuso nell'aprile 2025, con l'agenzia che ha segnalato che la guida finale — incorporando ampio feedback degli stakeholder su come gestire generative AI e large language models nello specifico, è prevista per il 2026.
Conclusione: fiducia condizionata, non fiducia cieca
La risposta onesta alla domanda se i regolatori possano fidarsi dei dati scientifici generati dall'AI non è né un semplice sì né un semplice no. È condizionata, basata su prove e attentamente proporzionata al rischio.
I regolatori non stanno costruendo quadri per escludere completamente l'AI dalla generazione di dati scientifici — il valore della tecnologia nell'accelerare la scoperta e nel migliorare sostanzialmente la qualità dei dati è già ampiamente dimostrato in molte aree terapeutiche.
Stanno invece costruendo quadri che richiedono la stessa rigore e responsabilità a un modello AI che hanno sempre richiesto alla scienza generata dall'uomo: affermazioni chiaramente definite, metodologia trasparente e prove proporzionate alle conseguenze di un errore.
Le agenzie che avranno successo non saranno quelle che si fidano dei dati AI in modo incondizionato, né quelle che li respingono d'istinto per eccesso di cautela.
Sarà chi costruisce infrastrutture durature come framework di credibilità, punteggi di fedeltà, rilevazione delle hallucination e valutazioni del rischio proporzionate, necessarie per distinguere in modo affidabile tra la scienza generata dall'AI che merita davvero fiducia e la scienza generata dall'AI che solo suona come se la meritasse.
Domande frequenti
1) I regolatori possono fidarsi dei dati scientifici generati dall'AI?
I regolatori possono fidarsi dei dati scientifici generati dall'AI solo quando esistono prove sufficienti che dimostrino che il sistema AI è affidabile per l'uso previsto. Gli attuali quadri normativi si concentrano sulla validazione della credibilità, della trasparenza e delle prestazioni dei modelli AI piuttosto che sull'accettazione acritica dei loro risultati. Il livello di scrutinio generalmente aumenta con il potenziale impatto che i dati generati dall'AI possono avere sulla sicurezza del paziente o sulle decisioni regolatorie. Questo approccio basato sul rischio aiuta a garantire che la fiducia sia guadagnata attraverso le prove e non presunta.
2) Cos'è la AI hallucination e perché è una preoccupazione per i regolatori?
L'allucinazione dell'IA si verifica quando un sistema di intelligenza artificiale genera informazioni che sembrano accurate e convincenti ma sono in realtà errate o completamente inventate. In contesti scientifici e normativi, le allucinazioni possono includere citazioni inventate, riepiloghi di dati inaccurati o conclusioni non supportate. Poiché questi output vengono spesso presentati con sicurezza e in un formato professionale, possono essere difficili da identificare durante le revisioni di routine. Ciò rende l'allucinazione una delle sfide più significative nella valutazione di contenuti scientifici generati dall'IA.
3) Che cos'è il dato sintetico e come viene utilizzato nella ricerca sanitaria?
I dati sintetici sono informazioni generate artificialmente da modelli di IA per replicare le caratteristiche di set di dati reali senza esporre informazioni effettive sui pazienti. Vengono spesso utilizzati per supportare la ricerca, addestrare modelli di machine learning e integrare dati clinici limitati. Sebbene i dati sintetici possano migliorare la protezione della privacy e la disponibilità dei dati, i regolatori devono garantire che riflettano accuratamente le condizioni del mondo reale. Una convalida adeguata è essenziale per confermare che i dataset sintetici non introducano bias nascosti o distorcano i risultati scientifici.
Reporting on the science, business and regulation shaping the pharmaceutical industry.
Altro in Regulatory Intelligence
Tutti gli articoli →
Lo schema dietro le FDA Warning Letters: cosa spesso trascurano startup e CDMO
Classi di cleanroom ISO 14644 per il settore farmaceutico (con implicazioni per il monitoraggio ambientale)
Discussion